
Street Fighter V Ditarik Sementara dari Steam, Mode Online Dimatikan
TeknologiCapcom mematikan sementara fungsi online Street Fighter V dan menariknya dari Steam setelah muncul masalah akibat celah keamanan PHP pekan lalu.
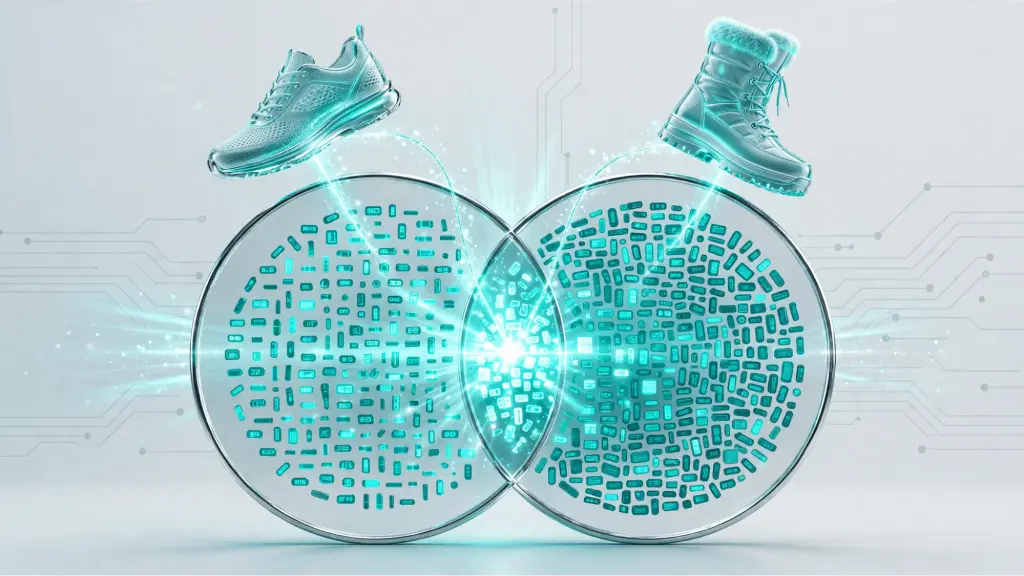
GenRecs Tokenization milik Meta memakai kosakata semantik stabil untuk rekomendasi iklan dan mencatat kenaikan konversi 0,35 persen.
Meta memperkenalkan GenRecs Tokenization, pendekatan representasi data yang menjadi fondasi bagi sistem rekomendasi iklan berbasis model bahasa besar (LLM) di perusahaan tersebut. Dipadukan dengan Generative Ads Model (GEM) dan Adaptive Ranking Model milik Meta, metode ini mencatat kenaikan konversi sebesar 0,35 persen di seluruh permukaan layanan bagi pengiklan. Angka itu berasal dari Meta Internal Data yang diukur pada Februari 2026.
Table of contents [Show]
GenRecs, singkatan dari Generative Recommenders, mengubah cara sistem rekomendasi iklan Meta membuat prediksi. Jika sebelumnya sistem menilai setiap kandidat iklan satu per satu, kini arsitektur LLM digunakan untuk menalar konten iklan dan preferensi pengguna secara bersamaan. Pengetahuan dunia yang telah dipelajari model dipadukan dengan pemahaman semantik tentang apa yang sebenarnya diwakili sebuah iklan, sehingga sistem tidak lagi hanya mencocokkan pola klik.
Dengan pendekatan itu, model dapat memprediksi iklan paling relevan bagi setiap orang, termasuk saat menampilkan produk yang benar-benar baru dan belum memiliki riwayat interaksi terhadap produk, iklan, maupun perusahaan.
Alih-alih menyimpan ID khusus untuk setiap konsep di dunia, model bahasa menyusun kosakata kecil berisi token semantik untuk merepresentasikan konsep apa pun. Karena token mendeskripsikan apa itu suatu item, termasuk iklan, produk, dan layanan, model dapat menghubungkan item yang belum pernah memiliki data interaksi dengan item yang sudah dikenalnya. Sebuah sepatu trail yang baru diluncurkan, misalnya, mewarisi apa yang sudah dipelajari model tentang kategori tersebut, bukan memulai representasi baru tanpa sinyal.
Pendekatan kosakata terstruktur ini memungkinkan GenRecs digunakan untuk retrieval maupun ranking pada semua jenis item dalam sistem, termasuk iklan, produk, halaman, dan piksel.
Menurut Meta, tokenisasi semantik memberi sejumlah manfaat dalam berbagai kasus penggunaan iklan:
Meta menjelaskan bahwa inti GenRecs Tokenization adalah pipeline tiga tahap:
Model multimodal terlatih membaca setiap iklan, produk, dan halaman, termasuk teks dan gambarnya, lalu mengodekannya menjadi embedding yang membawa pengetahuan dunia. Tokenizer menggabungkan sinyal konten itu dengan representasi yang dipelajari dari cara orang berinteraksi dengan item, kemudian mengkuantisasi hasilnya menjadi rangkaian pendek token diskret. Item yang mirip berbagi token, sebagaimana kata-kata yang berkerabat berbagi akar kata.
Untuk memaksimalkan kualitas rekomendasi iklan, kombinasi tahapan perlu disesuaikan dengan semantik entitas dan fitur. Pada banyak representasi iklan, GenRecs Tokenization memakai prefix n-gram yang menggabungkan encoder terlatih, dekomposisi residual, codebook vektor terlatih, dan parametrisasi token.
Meta menyebut kualitas model tokenizer dapat dievaluasi secara intrinsik, terlepas dari tambahan performa ranking di hilir, melalui tiga ukuran. Pertama, cluster purity, yaitu item yang berbagi satu kode cenderung berada dalam kategori yang sama sehingga sinyal per token lebih bersih. Kedua, distribution balance, yaitu item tersebar merata di antara ID semantik dan tidak menumpuk di sedikit ID. Ketiga, codebook utilization, yaitu semakin besar porsi kode yang menampung setidaknya satu item, semakin banyak perbedaan yang dapat diungkap kosakata.
Dari delapan versi tokenizer yang diuji, Meta melihat korelasi kuat antara metrik kualitas intrinsik tersebut dan akurasi prediksi ranking di hilir. Versi tokenizer yang mencetak skor lebih baik pada metrik itu juga memiliki akurasi prediksi CTR yang lebih baik untuk model iklan.
Tokenisasi disebut memaksimalkan efisiensi kampanye bervolume tinggi dengan menemukan pola semantik yang lebih dalam pada katalog produk yang besar. Bagi iklan ekor yang mengumpulkan lebih sedikit impresi, tokenisasi memungkinkan model rekomendasi menggeneralisasi melalui struktur konten yang sama, memulihkan performa cold-start, dan membuka transfer antar-entitas. Ketika sebuah merek pakaian olahraga meluncurkan sepatu trail musim berikutnya, tokenisasi membuat produk dan iklannya dapat bertumpu pada pembelajaran model dari sepatu musim sebelumnya, bahkan sebelum ada orang yang melihat iklan baru tersebut.
Dengan memperbaiki kualitas prediksi iklan ekor, tokenisasi tidak hanya membuat iklan ekor diperingkat secara akurat, tetapi juga meningkatkan data pelatihan yang kemudian memperbaiki kualitas prediksi untuk semua iklan. Setiap putaran pada flywheel yang menguatkan diri ini meningkatkan kualitas prediksi model.
Perbaikan tokenizer tidak terbatas pada model yang disetel khusus. Menurut Meta, mengoptimalkan kualitas codebook melalui diversity loss, dead code resets, dan contrastive objectives menghasilkan performa hilir yang terukur lebih baik ketika token yang dihasilkan dipakai untuk melatih generative recommender. Arsitektur two-tower yang dibangun di atas encoder LLM bersama disebut mencapai kualitas retrieval state-of-the-art dan tetap efisien untuk disajikan, menyamai performa two-tower klasik dengan sebagian kecil data pelatihan. Di atas fondasi itu, Meta kini memperluas ranking yang sadar penalaran menggunakan kosakata yang sama.
Meta menyebut pihaknya terus mendorong GenRecs Tokenization menuju titik optimal dari sisi laba atas investasi melalui tiga arah. Pertama, memperdalam generalisasi cold-start dengan memperluas cakupan tokenisasi ke seluruh item, karena inventaris iklan ekor menjadi tempat token semantik paling berkontribusi dan dampak bagi pengiklan paling besar. Kedua, menjadikan kualitas tokenizer sebagai tujuan utama melalui pelatihan yang selaras dengan engagement, kosakata lintas entitas yang terpadu, dan perbaikan codebook, sehingga iterasi dapat dilakukan tanpa menunggu satu siklus pelatihan model penuh.
Ketiga, menyajikan arsitektur LLM-native secara efisien. Tokenisasi yang sepenuhnya diverbalisasi memberi model pandangan terkaya atas sebuah iklan, tetapi membutuhkan jendela konteks yang tidak praktis pada skala iklan. Meta menggabungkan token verbalized yang dipadatkan dengan ID semantik agar kualitas penalaran tetap terjaga dengan latensi yang dapat diterima.
Ke depan, Meta mengeksplorasi apakah kosakata yang sama dapat menyatukan representasi lintas permukaan. Ruang token bersama yang mencakup konten iklan dalam teks, gambar, audio, dan video akan memungkinkan model menalar minat seseorang dan penawaran pengiklan dengan satu representasi, bukan menambal embedding yang dipelajari secara terpisah.
Seiring sistem rekomendasi bergeser dari penilaian diskriminatif menuju penalaran generatif, fondasi datanya pun bergerak dari ID yang bersifat sementara ke representasi semantik yang stabil. GenRecs Tokenization disebut menjadi fondasi yang menerjemahkan kompleksitas ekosistem iklan Meta ke dalam kosakata yang dapat dipelajari, dinalar, dan dijadikan dasar generasi oleh model generatif.
Sumber: Meta Engineering
Capcom mematikan sementara fungsi online Street Fighter V dan menariknya dari Steam setelah muncul masalah akibat celah keamanan PHP pekan lalu.
Jensen Huang menyebut lisensi software AI NVIDIA bisa mencapai US$2.000 per GPU per tahun, sekitar Rp36 juta, sebagai ilustrasi potensi bisnis.
Artifact management menghubungkan build CI/CD dengan deployment yang dapat dilacak dan direproduksi, diperkuat SBOM, signing, dan provenance.